이지대리
PDF 글자 추출하는 방법, 텍스트 선택부터 스캔 PDF OCR까지
링크를 복사했어요
- 드래그했을 때 글자가 파랗게 선택되는 PDF는 그대로 복사하면 됩니다.
- 스캔하거나 사진으로 찍어 만든 PDF는 글자가 이미지로 저장돼 있어 OCR(문자 인식)로 변환해야 합니다.
- 민감한 문서라면 파일을 외부 서버에 올리지 않는 방법을 고르는 것이 안전합니다.
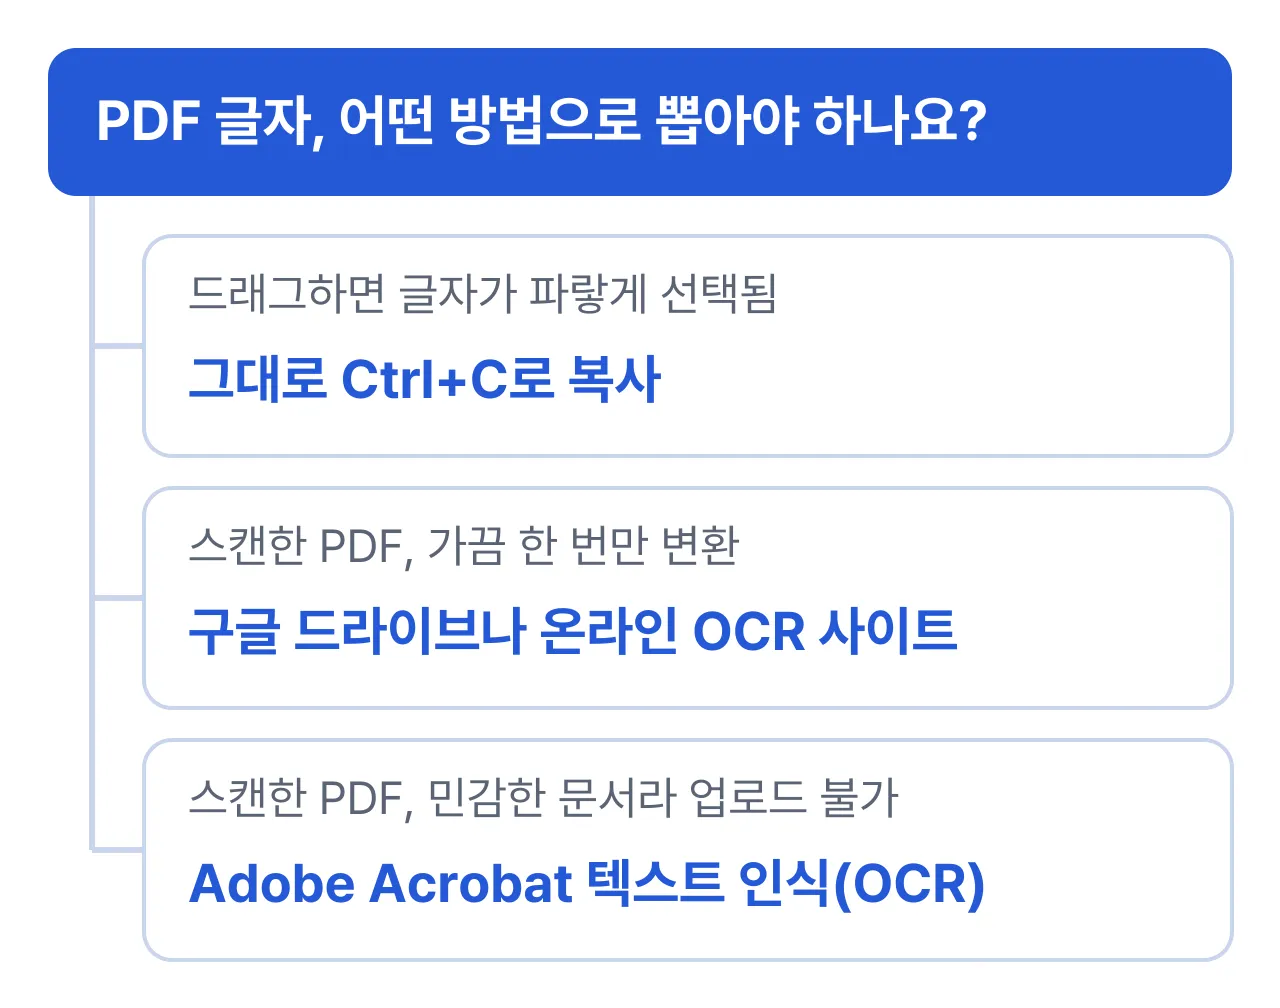
PDF에서 글자만 뽑아내려면 먼저 그 PDF에 선택 가능한 텍스트가 있는지부터 확인해야 합니다. 마우스로 드래그했을 때 글자가 파랗게 선택되면 텍스트가 있는 PDF라 바로 복사하면 되고, 선택 영역 없이 화면 전체가 사진처럼 끌려가면 스캔하거나 사진으로 찍어 만든 이미지 PDF라 OCR(문자 인식) 과정을 거쳐야 합니다. 이미지 PDF는 구글 드라이브로 무료 변환하거나, Adobe Acrobat의 텍스트 인식 기능, 온라인 OCR 사이트 중에서 상황에 맞게 고르면 됩니다.
방법별 비교
| 방법 | 추가 설치 | 파일 외부 전송 | 이런 경우 추천 |
|---|---|---|---|
| 드래그해서 바로 복사 | 없음 | 없음 | 글자가 선택되는 PDF일 때 |
| 구글 드라이브로 변환 | 없음(구글 계정 필요) | 있음 (드라이브 업로드) | 스캔한 PDF를 가끔, 무료로 변환할 때 |
| Adobe Acrobat 텍스트 인식(OCR) | 필요(유료) | 없음 | 스캔한 PDF를 자주, 내 PC에서 처리할 때 |
| 온라인 OCR 사이트 | 없음 | 있음 (서버에 업로드) | 가끔 한 번만, 민감하지 않은 문서일 때 |
PDF 글자가 드래그해도 선택되지 않는 이유는 무엇인가요?
스캔하거나 사진으로 찍어 PDF로 만든 문서는 글자가 텍스트가 아니라 페이지 전체가 하나의 이미지로 저장돼 있기 때문입니다. 이런 PDF는 눈으로 보면 보통 문서와 똑같이 보이지만, 한 글자 위에서 마우스를 드래그해도 선택 영역이 생기지 않고 화면 전체가 사진처럼 끌려갑니다. 반대로 워드나 한글 문서를 PDF로 내보내거나 “인쇄하여 PDF로 저장”한 문서는 대부분 글자가 그대로 텍스트로 남아 있어 바로 선택할 수 있습니다. 어느 쪽인지 헷갈린다면 아무 글자 위에서 한 번 드래그해 보는 것이 가장 빠른 확인 방법입니다.
방법 1. 텍스트가 있는 PDF는 그냥 선택해서 복사하기
글자가 선택되는 PDF라면 별도 프로그램 없이 끝납니다.
- PDF를 엣지(Edge)나 쓰고 있는 PDF 뷰어로 엽니다.
- 뽑고 싶은 부분을 마우스로 드래그해 선택합니다. 전체가 필요하면 Ctrl + A로 한 번에 전체를 선택할 수 있습니다.
- Ctrl + C로 복사한 뒤 메모장이나 문서에 붙여넣습니다.
이 방법은 설치도 필요 없고 파일이 외부로 전송되지도 않아 가장 간단합니다. 다만 글자 수가 아주 많은 문서는 페이지마다 나눠서 선택해야 할 수 있습니다. 반대로 필요한 페이지만 따로 뽑아 작업하고 싶다면 PDF 페이지 나누기로 먼저 분량을 줄여 두는 것도 방법입니다.
방법 2. 구글 드라이브로 스캔한 PDF를 텍스트로 변환하기
스캔한 PDF나 사진 파일이라면 구글 드라이브로 무료로 변환할 수 있습니다. 구글 공식 고객센터에 따르면 파일을 드라이브에 올린 뒤 Google 문서로 열면 자동으로 글자를 인식해 텍스트로 바꿔 줍니다.
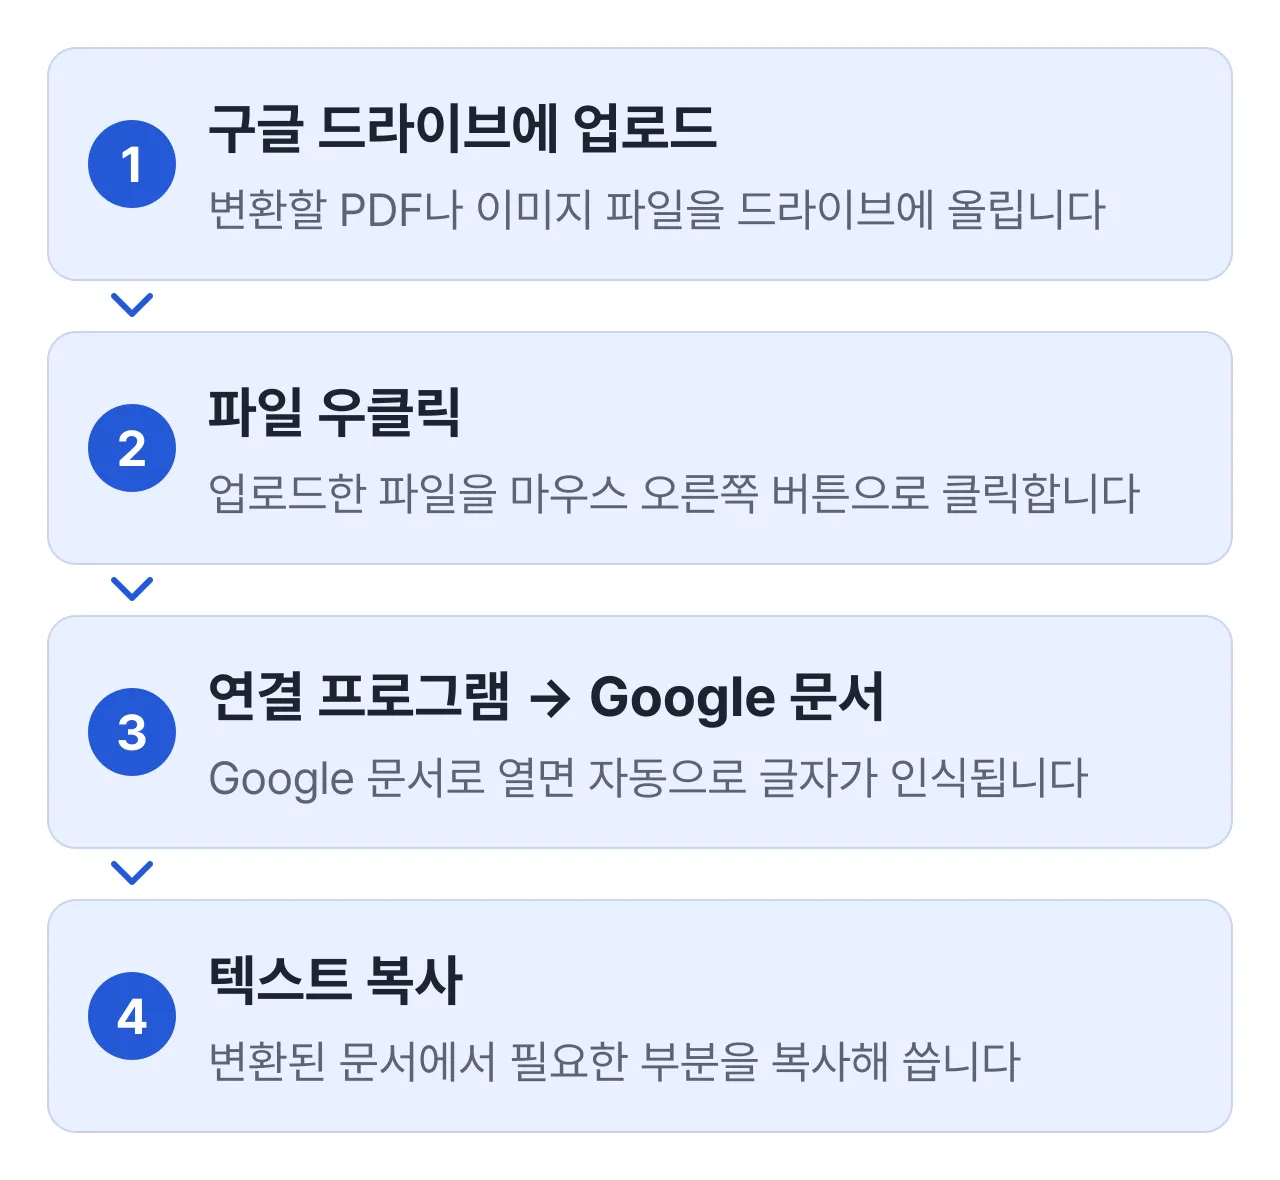
- 컴퓨터에서 구글 드라이브에 접속해 변환할 PDF를 업로드합니다.
- 업로드한 파일을 마우스 오른쪽 버튼으로 클릭합니다.
- 연결 프로그램에서 Google 문서를 선택합니다.
- 파일이 자동으로 인식되어 Google 문서로 열리면, 필요한 부분을 복사해 씁니다.
구글 공식 고객센터에는 몇 가지 제한이 안내돼 있습니다. 파일 크기는 2MB 이하, 글자 높이는 최소 10픽셀 이상이어야 하고, 문서가 거꾸로 돼 있다면 업로드 전에 바로 회전해야 합니다. 굵기·기울임·글자 크기 같은 서식은 대체로 유지되지만, 목록·표·여러 단·각주는 제대로 인식되지 않을 가능성이 높다고 안내돼 있습니다. 또한 변환하려면 파일을 구글 드라이브에 업로드해야 하므로, 계약서나 개인정보가 담긴 문서라면 이 방법보다 방법 3을 쓰는 편이 안전합니다.
방법 3. Adobe Acrobat의 텍스트 인식(OCR) 기능 쓰기
파일을 외부에 올리지 않고 내 프로그램 안에서 처리하고 싶다면 Adobe Acrobat의 텍스트 인식(OCR) 기능을 쓸 수 있습니다. Adobe 공식 도움말에 따르면 스캔한 PDF를 Acrobat에서 연 다음 텍스트 인식 대화상자에서 페이지 범위와 언어를 선택하고 실행하면, 이미지로 된 글자를 검색 가능하고 선택 가능한 텍스트로 변환합니다. 변환이 끝나면 방법 1과 마찬가지로 드래그해서 복사할 수 있습니다.
다만 이 기능은 무료로 배포되는 Acrobat Reader에는 없고, 유료 Acrobat 버전이 있어야 쓸 수 있습니다. 이미 회사에서 Acrobat 정품을 쓰고 있다면, 민감한 문서를 외부에 올리지 않고 변환할 수 있는 가장 확실한 방법입니다.
방법 4. 온라인 OCR 사이트 이용하기
설치 없이 브라우저에서 가장 빠르게 변환할 수 있는 방법입니다. 사이트에 PDF나 이미지 파일을 올리면 인식된 텍스트를 바로 보여주거나 내려받을 수 있습니다. 다만 파일이 해당 사이트의 서버로 전송된다는 점을 기억해야 합니다. 대부분 무료로 쓸 수 있지만 하루 처리 횟수나 파일 용량에 제한을 두는 경우가 많고, 가끔 한 번만 쓰고 민감하지 않은 문서일 때 쓰는 편이 적당합니다.
스캔한 PDF에서 추출한 글자가 틀리게 나오면 어떻게 하나요?
사진 품질이 낮거나 표·여러 단으로 구성된 문서라면 OCR 인식 오류가 흔히 생기기 때문입니다. 해상도가 낮은 스캔본, 기울어진 사진, 손글씨가 섞인 문서는 인식률이 떨어져 글자가 다르게 나오거나 줄바꿈이 엉뚱한 곳에서 끊기는 경우가 많습니다. 화면이나 사진 속 글자를 인식하는 원리는 이미지 속 글자 추출하는 방법에서도 다뤘듯 결과물을 그대로 쓰기보다 한 번 더 읽어보고 틀린 부분을 고치는 과정이 필요합니다. 가능하면 변환 전에 스캔 해상도를 높이고 문서를 반듯하게 맞춰 두는 것이 인식률을 높이는 가장 간단한 방법입니다.
마무리 체크리스트
- 먼저 PDF의 글자를 드래그해 봅니다. 파랗게 선택되면 텍스트 PDF, 선택되지 않으면 이미지(스캔) PDF입니다.
- 텍스트 PDF는 Ctrl+A, Ctrl+C로 바로 복사합니다.
- 이미지 PDF는 구글 드라이브, Adobe Acrobat 텍스트 인식, 온라인 OCR 사이트 중 하나로 변환합니다.
- 계약서나 개인정보가 담긴 문서는 업로드가 필요한 구글 드라이브·온라인 사이트보다 내 PC에서 처리하는 방법을 고릅니다.
- 열 때 비밀번호를 묻는 PDF라면 PDF에 암호 거는 방법과 해제할 때 주의할 점을 참고해 먼저 암호를 해제합니다.
- 변환된 텍스트의 표, 줄바꿈, 특수문자는 붙여넣은 뒤 한 번 더 확인합니다.
참고 자료
자주 묻는 질문
PDF 글자가 드래그해도 선택되지 않아요. 왜 그런가요?
스캔하거나 사진으로 찍어 만든 PDF는 글자가 아니라 페이지 전체가 이미지로 저장돼 있기 때문입니다. 이 경우 바로 복사할 수 없고 OCR(문자 인식)로 변환하는 과정이 필요합니다.
추출한 텍스트에 표나 여러 단 구성이 깨져서 나와요.
OCR은 이미지 속 글자 모양을 인식하는 방식이라 표, 여러 단, 각주처럼 복잡한 배치는 그대로 재현하지 못하는 경우가 많습니다. 붙여넣은 뒤 줄바꿈과 배치를 직접 정리해야 합니다.
비밀번호가 걸린 PDF도 글자를 뽑을 수 있나요?
대부분의 방법은 열 때 비밀번호를 묻는 PDF를 바로 처리하지 못합니다. 먼저 암호를 해제한 뒤 진행해야 합니다.
이 글은 이지랩(ezLab)이 운영하는 이지대리에서 작성했습니다. 일부 글에서 이지랩(ezLab)의 무료 프로그램을 해결 방법 중 하나로 소개합니다.